Feed流系统的六个经典问题
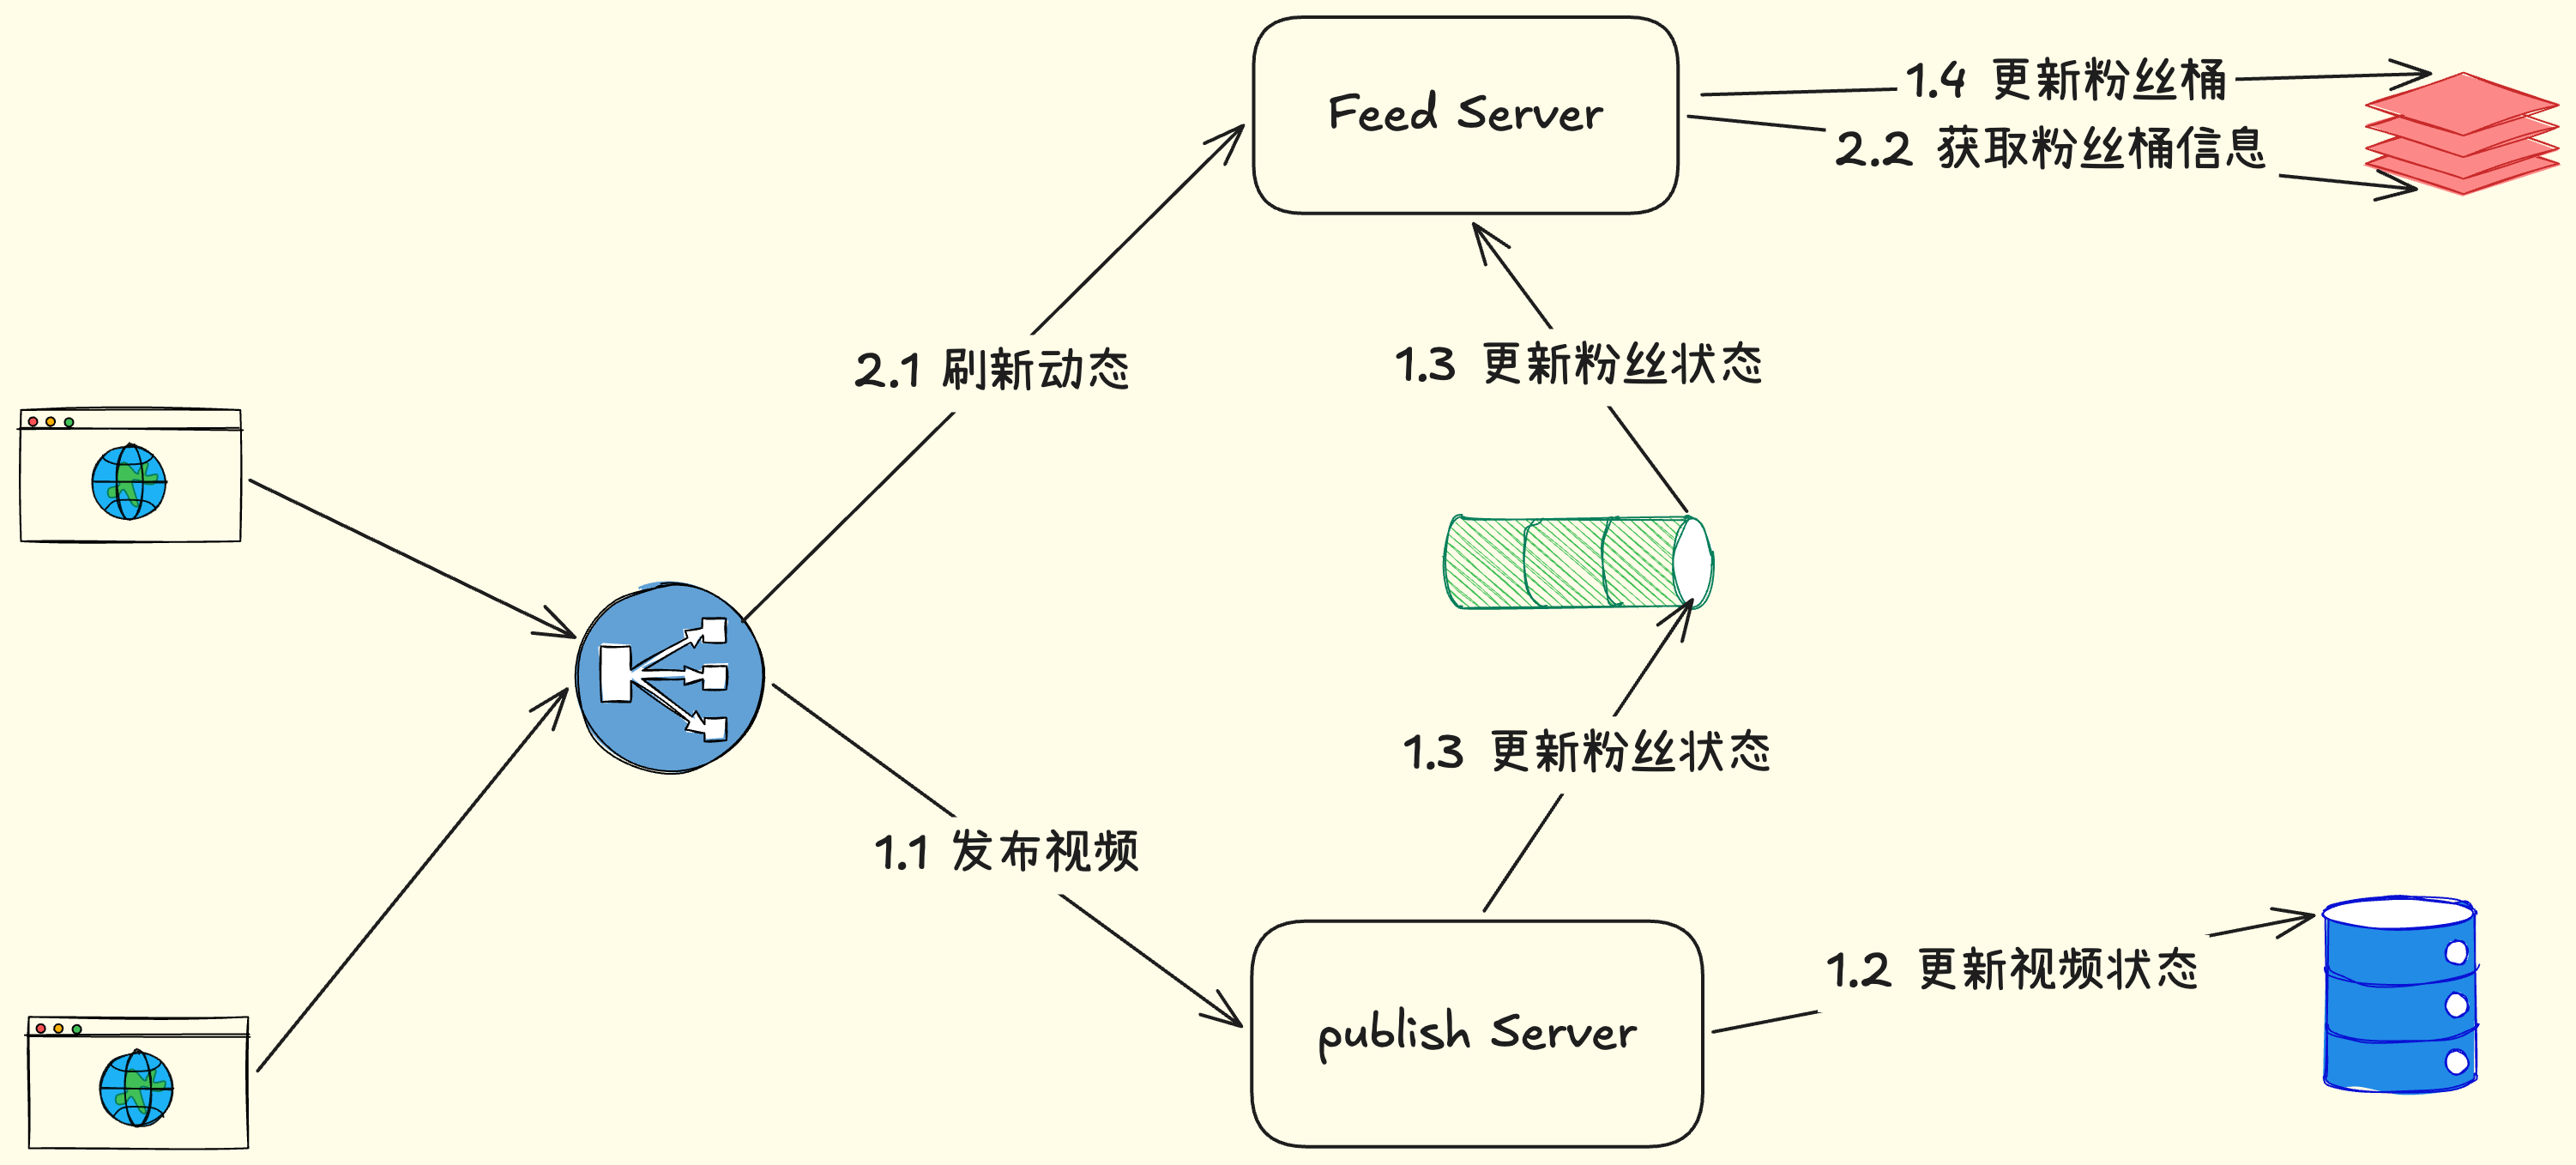
Feed 流系统的架构与六个经典问题。 存在的问题: 深分页问题 现象:用户一次feed流拉了500多页数据,redis放不下只能去DB里查,这时候MySQL要执行耗时很长的命令 出现的问题: 用户层面:数据很慢,或者根本拿不到数据 C端:超时重试,一直占着连接池,资源被浪费 Server侧:同C端 DB侧:进行无意义的回表,整个磁盘IO队列阻塞 123-- 第 500 页:数据库先扫到第 10000 行,再往后取 20 行,前 10000 行白扫SELECT v.* FROM feed_item f JOIN video v ON f.video_id = v.idWHERE f.user_id = ? ORDER BY f.publish_ts DESC LIMIT 20 OFFSET 10000 深度分页介绍及优化建议 解决办法: 禁止深度分页,C端直接设置最大分页数,超过这个分页数禁止请求 建立游标,每次请求结束都带着一个NextID,用于直接跳到下一页的开始 1234-- cursor =...
软考:软件架构风格与论文模板
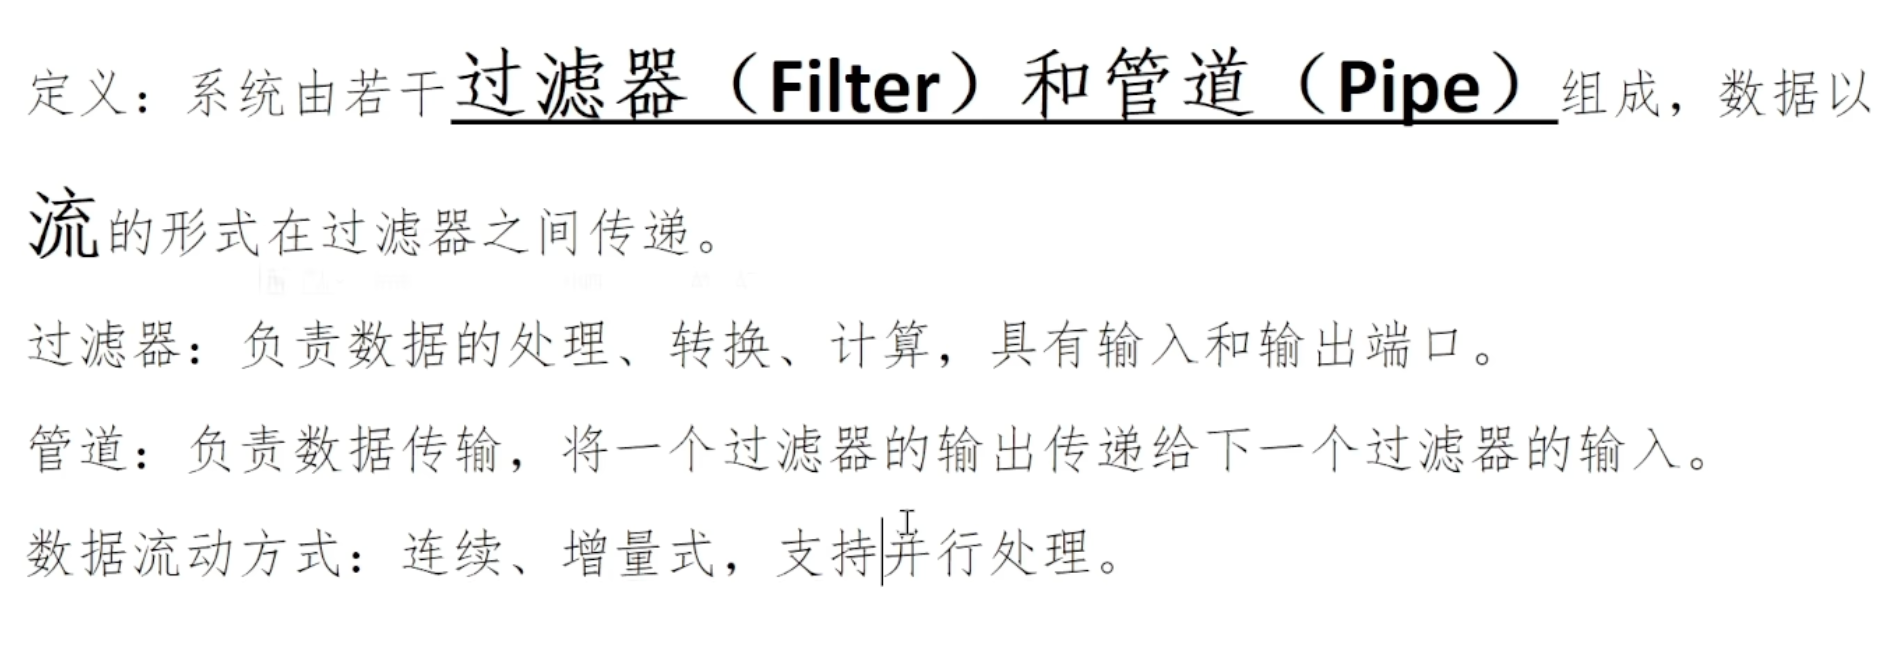
一、质量属性:敏感点与权衡点 敏感点:为了实现某种特定的质量属性,一个或多个构建所具有的特性 权衡点:影响多个质量属性的特性,是多个质量属性的敏感点 二、软件架构风格 1. 数据流风格 批处理风格 场景:日志处理、每日的数据清洗 优点:实现简单、便于调试、可处理大批数据 缺点:实时性差、资源利用率低 管道-过滤器 优点:并行可插拔、易维护、可拓展 缺点:不适合交互、单向数据流不适合复杂业务系统、IO 传输有性能开销 场景:Unix 命令、编译器、音频处理、数据流处理 2. 调用/返回风格 主程序/子程序 场景:小型软件 优点:结构简单、开发成本低、易理解 缺点:耦合度高、拓展性差 层次 定义:每一层根据职责不同划分不同的层次,下层为上层提供服务,上层仅依赖下层,禁止跨层调用或反向依赖 场景:MVC...
RAG-Core
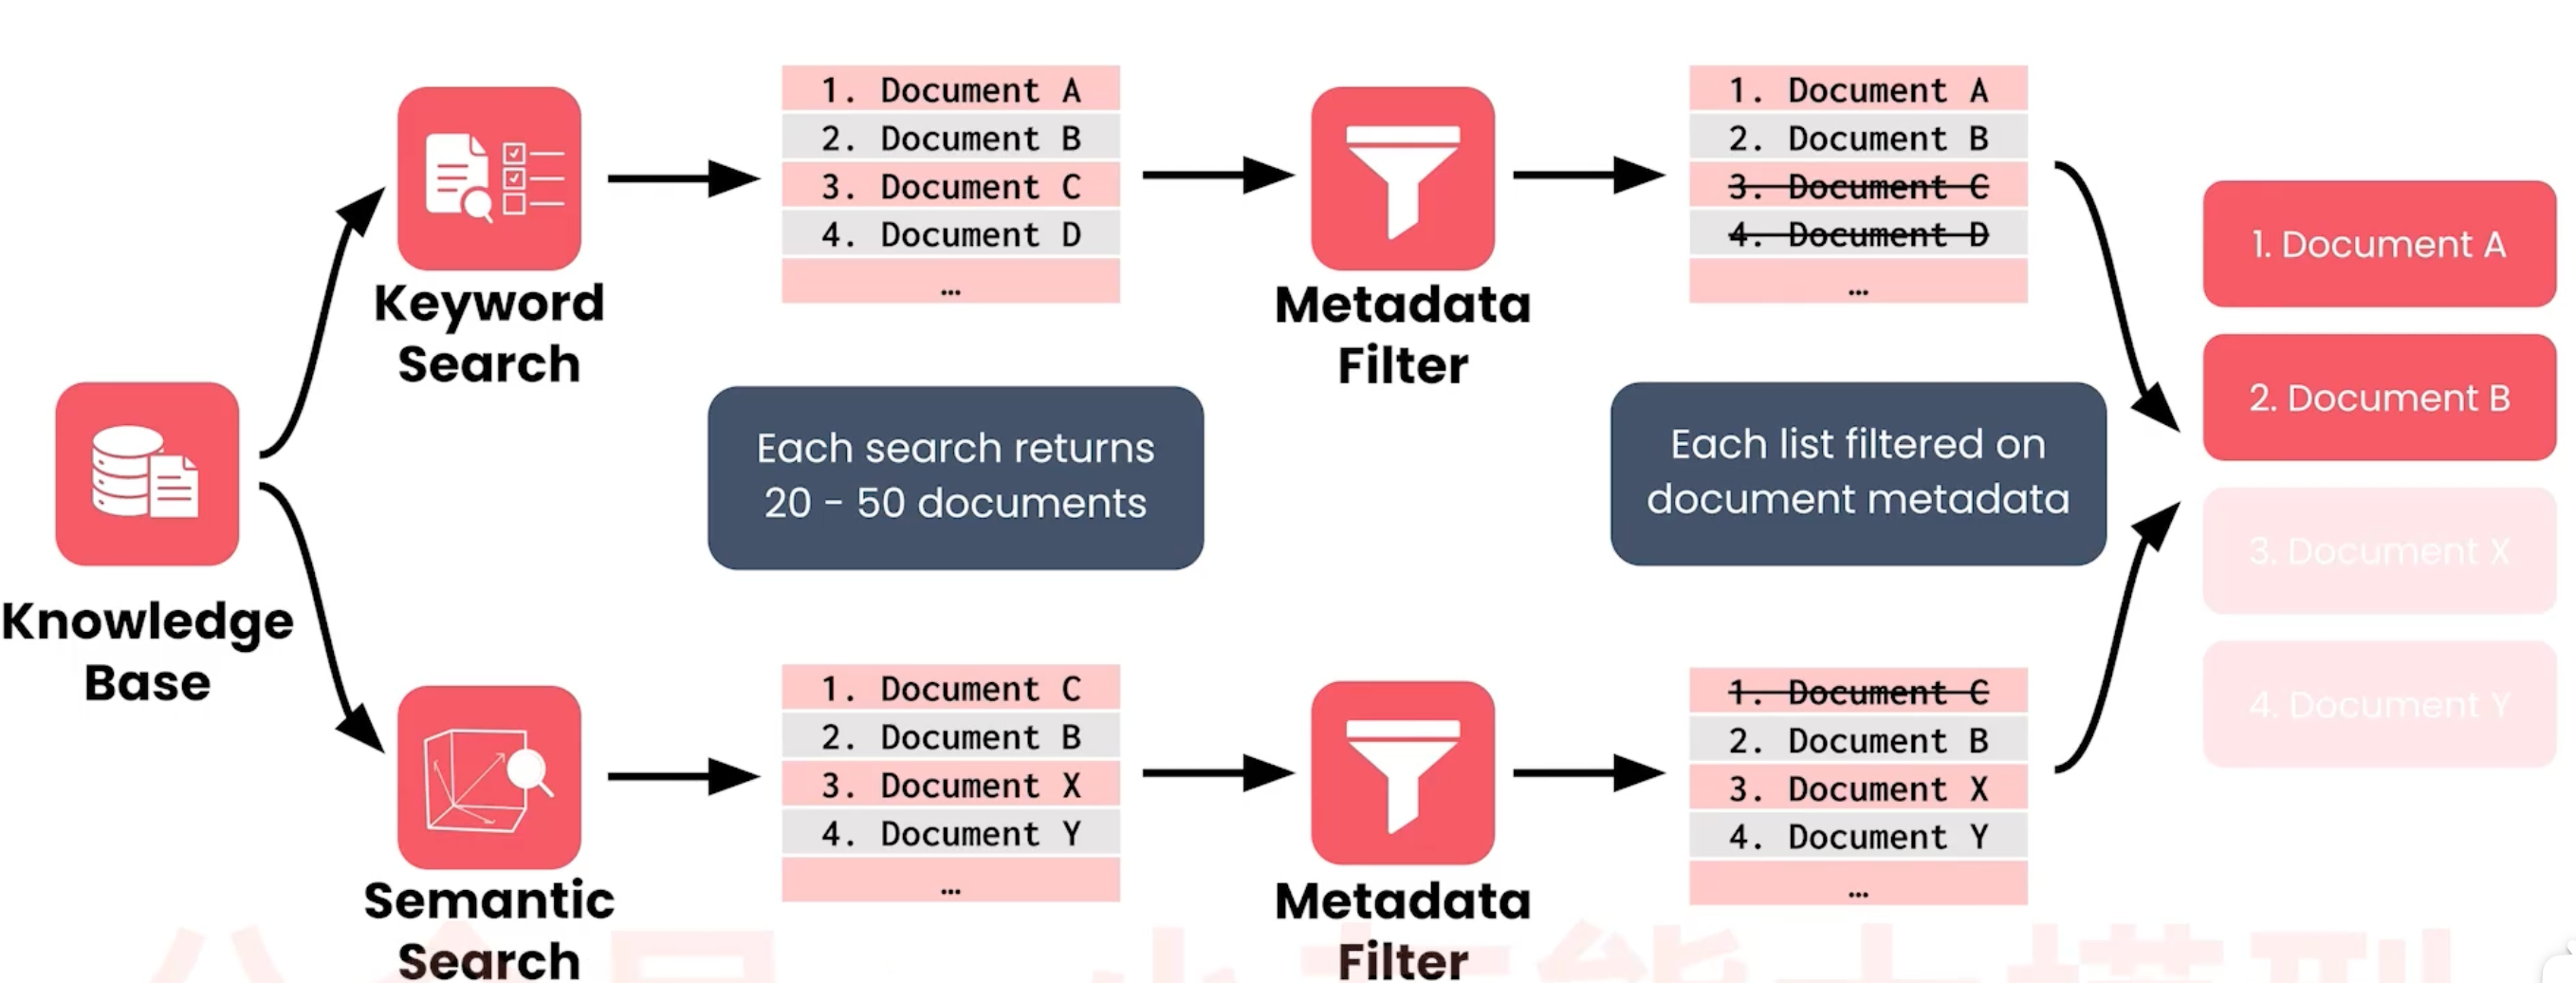
记录由这篇课程得到的一些关于RAG的启发。 What RAG RAG:检索增强,就像他的名字一样,RAG的过程大概就分为两个部分 Retrive(检索) 我们知道LLM的原理就是通过你输入的Prompt不断预测下一个词,而且这个词的概率会随着**上下文(Context)**的变化而变化,RAG就是通过改变Prompt或者说Context的方式,影响模型的回答。 向量数据库已经被认为是比传统数据库更高效的一种检索库 在我们输入一段初始的Prompt,模型在处理上下文的时候,系统会先通过某个编码器(Embedding)将文本convert成向量,然后去向量数据库(Vector...
2026-7-19
项目思考 12345运行架构:参与建设轻量级 AI Agent 运行时,打通 CLI、Gateway、WebUI、OpenAI-compatible API 四类核心交付入口,将消息总线、Agent Loop、Session、Cron、Heartbeat 等能力解耦并下沉到统一运行时中,实现多形态接入与底层能力的一次开发、多端复用。执行闭环:围绕工具调用型 LLM 执行链路实现多轮推理、流式响应、子代理协作、上下文裁剪与中断恢复等核心能力,形成覆盖消息接入 → 推理执行 → 会话持久化 → 结果分发的完整 Agent 执行闭环,保障复杂任务在长链路下的稳定性与可恢复性。扩展体系:完善多渠道与多模型扩展体系,仓库内置 15 个聊天渠道模块与 35 个 Provider 配置项,并沉淀 Session、Memory、Cron、Heartbeat...
LeetCode22:括号生成
LeetCode22:括号生成 22. 括号生成 - 力扣(LeetCode) 数字 n 代表生成括号的对数,请你设计一个函数,用于能够生成所有可能的并且 有效的 括号组合。 思路: 最直接的思路,构建一个长度为2n的数组,针对每个位置枚举两种情况,最后校验生成的字符串是否合格(显然这个指数级别的时间复杂度不满足条件) 仔细思考左括号和右括号的限制条件(在第一个思路上进行减枝),对于当前持有left个左括号和right个右括号的数组来说,需要满足 左括号数量必须小于n 右括号数量必须小于左括号 基于此我们可以得到加括号的限制条件: 如果左括号的数量小于n,仍可以继续插入左括号 如果右括号的数量小于左括号,仍可以插入右括号 递归出口为右括号已经全部插入 代码实现如下: {fold}1234567891011121314151617181920212223242526272829303132333435363738394041424344454647class Solution { public...
2026.4.1
怎么保证Mysql的主从一致性 根据一致性有低到高,Mysql分为异步复制、半同步复制、组复制。异步复制是将binlog文件发送给从节点就不管了,半同步复制是只要有一个从节点告知主节点已经将binlog复制完毕,主节点就返回插入完成的消息,组复制就需要大多数节点都告知主节点复制完毕,主节点才会返回。 如何使用redis实现分布式锁 1SET lock_key unique_value NX PX 30000 lock_key:锁的名字。 unique_value:关键点! 每个客户端生成的随机唯一 ID(如 UUID)。用于释放锁时校验“这把锁是不是我加的”。 NX:只有 key 不存在时才设置成功(保证互斥)。 PX 30000:设置 30...
2026.3.31
...
2026.3.30
230. 二叉搜索树中第 K 小的元素 给定一个二叉搜索树的根节点 root ,和一个整数 k ,请你设计一个算法查找其中第 k 小的元素(k 从 1 开始计数)。 思路:遍历顺序肯定是中序,才能用上搜索树的性质。 全局记录答案。 123456789101112131415161718192021class Solution { private int ans; private int k; public int kthSmallest(TreeNode root, int k) { this.k = k; dfs(root); return ans; } // 左中右遍历,在根节点k--。 private void dfs(TreeNode node) { if (node == null || k <= 0) { return; } dfs(node.left); //...
2026.3.29
xxl-job对比其他定时任务处理器的优势 支持动态更新cron表达式 日志写入 任务失败通知 提供可视化监控 支持分布式任务 IOC的原理 项目启动的时候会扫描所有类是否包含容器化管理的注解,如果有先将类信息统一封装成BeanDefination的规范,然后通过反射机制调用空参构造函数进行实例化,然后进行依赖注入,调用初始化方法,以及postconstruct注解方法,进行aop增强,包装成bean对象后放入IOC容器中 1.项目启动不会扫描所有类,而是扫描包路径下带有@bean和@component类 2.不一定调用空参构造 3.依赖注入需要注意循环引用问题 4.postconstruct -> init -> 自定义init ->...
多线程的一些工具类
countdownlatch 1234567891011121314151617181920public class Main { public static void main(String[] args) throws InterruptedException { // 主线程等待n个子线程,每次调用countdown表示该线程准备好了 CountDownLatch latch = new CountDownLatch(2); new Thread(() -> { System.out.println("线程1执行"); latch.countDown(); }).start(); new Thread(() -> { System.out.println("线程2执行"); ...