Feed流系统的六个经典问题
Feed 流系统的架构与六个经典问题。
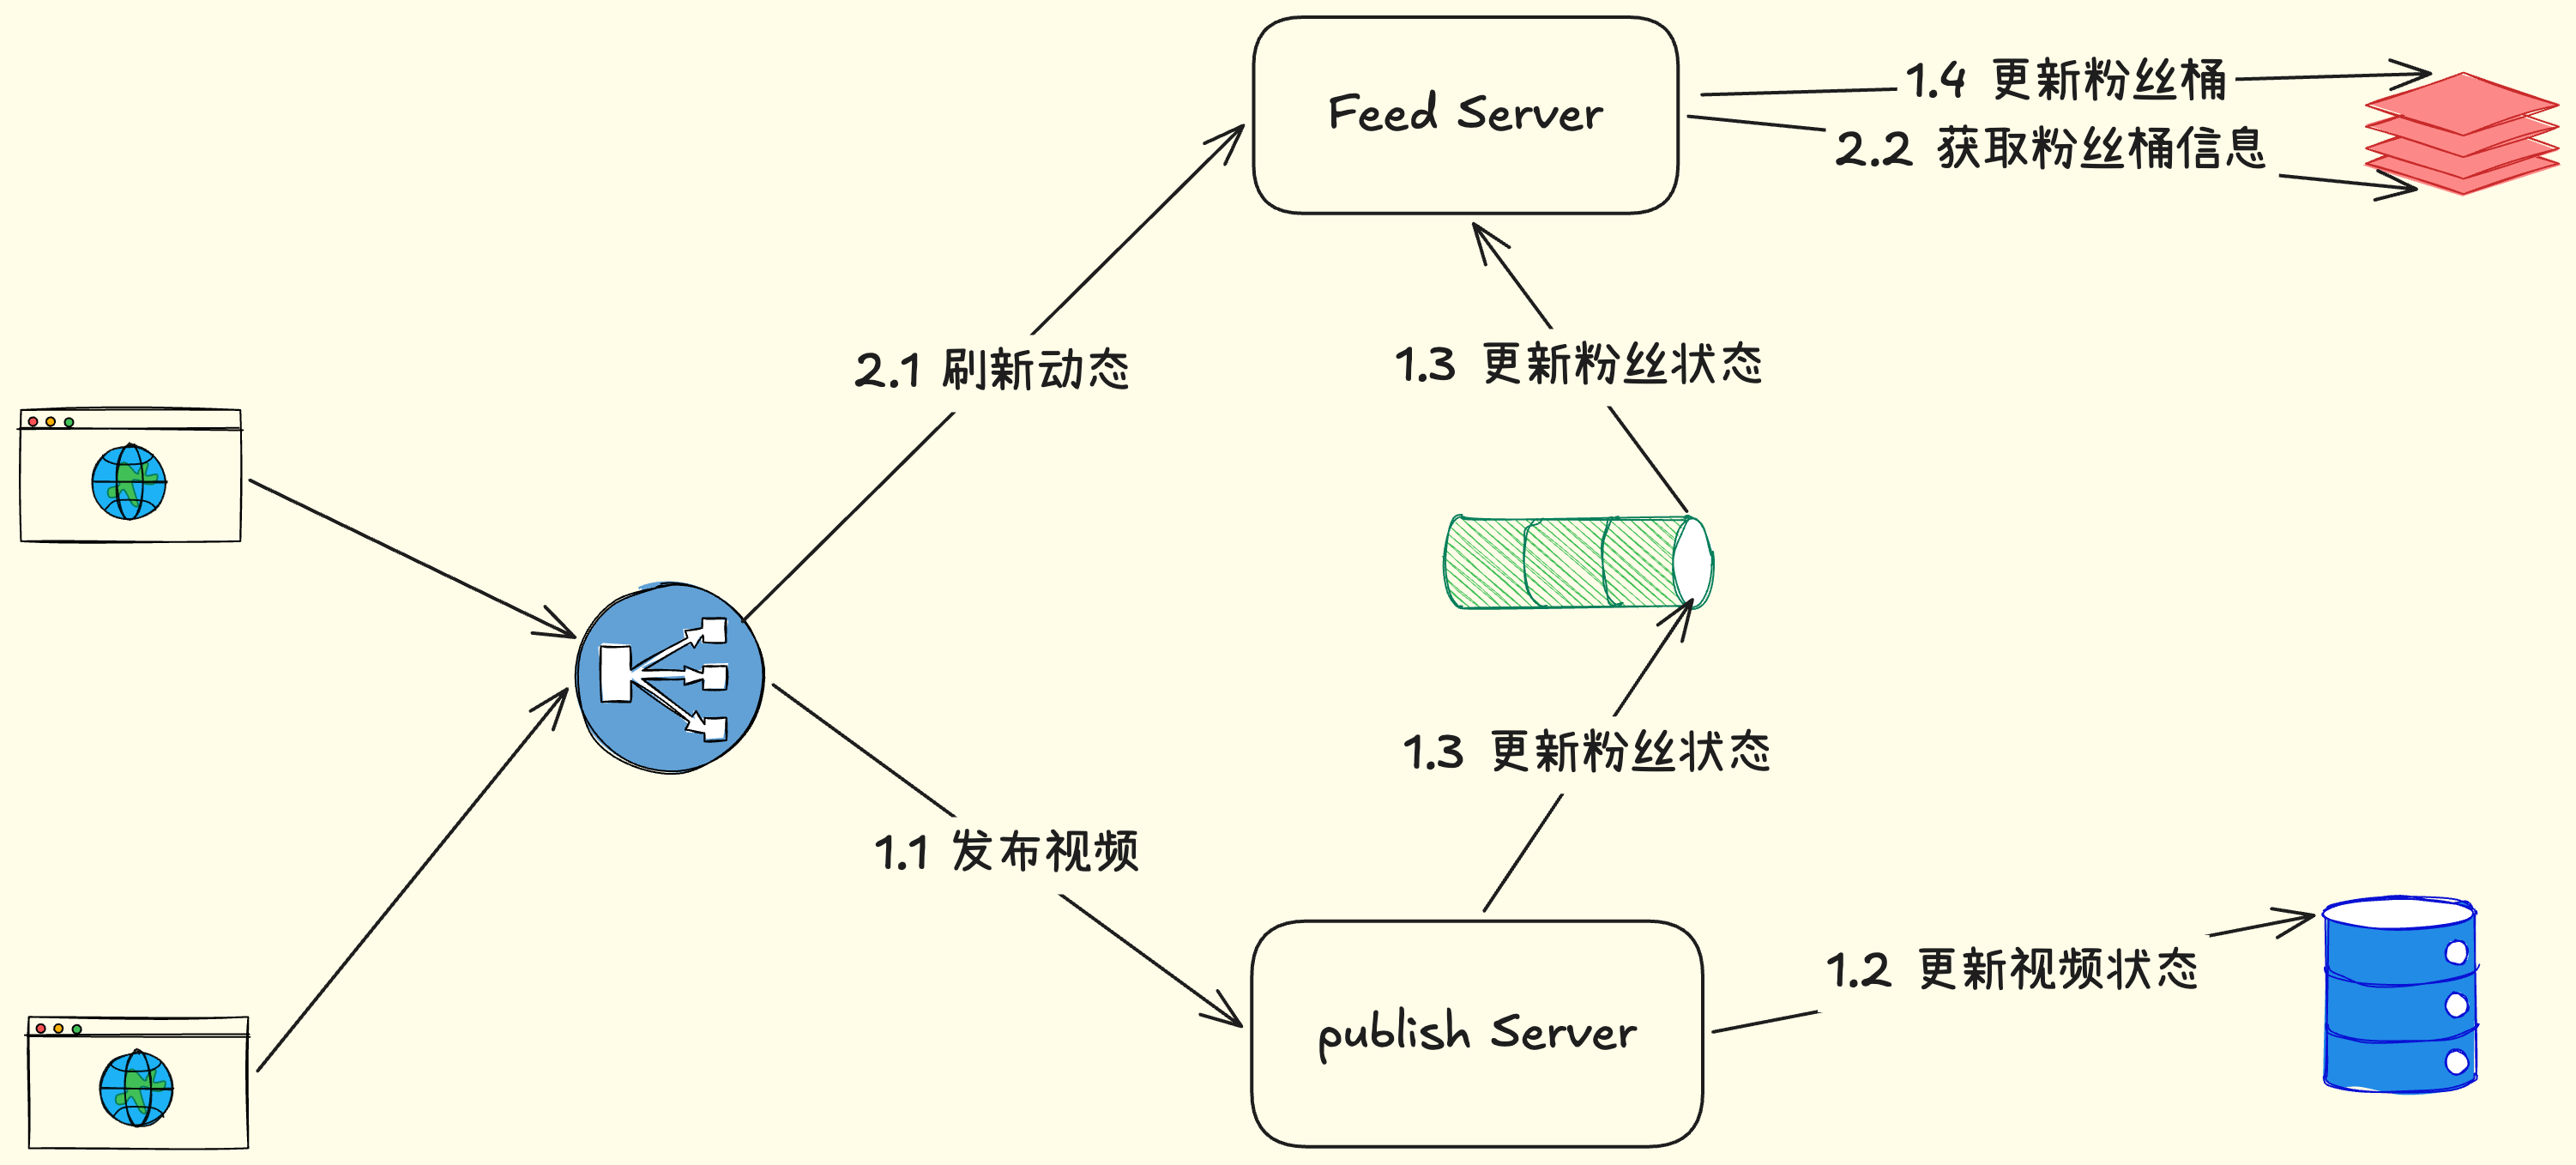
存在的问题:
-
深分页问题
现象:用户一次feed流拉了500多页数据,redis放不下只能去DB里查,这时候MySQL要执行耗时很长的命令
出现的问题:
- 用户层面:数据很慢,或者根本拿不到数据
- C端:超时重试,一直占着连接池,资源被浪费
- Server侧:同C端
- DB侧:进行无意义的回表,整个磁盘IO队列阻塞
1
2
3
-- 第 500 页:数据库先扫到第 10000 行,再往后取 20 行,前 10000 行白扫
SELECT v.* FROM feed_item f JOIN video v ON f.video_id = v.id
WHERE f.user_id = ? ORDER BY f.publish_ts DESC LIMIT 20 OFFSET 10000解决办法:
-
禁止深度分页,C端直接设置最大分页数,超过这个分页数禁止请求
-
建立游标,每次请求结束都带着一个NextID,用于直接跳到下一页的开始
1
2
3
4
-- cursor = "publish_ts:video_id",由服务端编码、客户端原样回传
SELECT id, publish_ts FROM feed_item
WHERE user_id = ? AND (publish_ts, video_id) < (?, ?) -- 比锚更旧的
ORDER BY publish_ts DESC, video_id DESC LIMIT 20
-
看到旧/重复视频
现象:用户漏/重复看视频
1
2
3
第 1 页: OFFSET 0 → [新视频A, v1, v2, ..., v19] -- A 刚被 删除
-- 用户看第 1 页的几秒里,另一个 UP 主发了 B,插到最前面:
第 2 页: OFFSET 20 → 整列后移一位,返回 [v19, v20, ...] -- v19 第 1 页出现过插入一行,OFFSET 20 指向的内容就从 v20 变成 v19,重复和漏看是同一个 bug 的两面。
本质是通过分页参数控制查询时,如果数据有增删,就会对后续的查询造成影响
解决办法:
- 基于时间过滤掉旧的数据,在本地进行视频去重
- 加入游标,不需要关注数据变化,直接从下一条开始取数
-
缓存穿透
现象:某个大V的Key有几百万个用户一直访问,但是这个大V的Key突然过期了,几十上百万流量直接打DB,导致数据库崩溃
1
2
3
4
feed = redis.Get("feed_page:{uid}")
if feed == nil: # key 过期瞬间,所有并发请求同时走到这里
feed = build(uid) # 慢路径:收件箱 + 大V合并,几十毫秒
redis.Set("feed_page:{uid}", feed, 300)解决办法:
-
热Key永不过期:热点Key不设置过期时间,靠定时任务更新缓存
1
2
3
# 后台定时任务:遍历全量 feed_page key 逐个重建
for uid in all_users(): # 几十万个 key 逐个点名
redis.Set("feed_page:"+uid, build(uid), ttl=0) # ttl=0 永不过期,靠任务刷 -
逻辑过期:设置一个时间戳,每次访问Key的时候顺便对比一下,如果过期了就重新拉一次缓存
1
2
3
4
5
6
7
8
9
10
feed = redis.Get("feed_page:{uid}")
if feed != nil && !feed.Expired(): # 没过期直接用
return feed
# 到期不删 key,直接返回旧值并异步刷新;重建交给单飞保证只发生一次
val, _, _ := singleflight.Do("feed:"+uid, func() interface{} {
fresh := build(uid)
redis.Set("feed_page:{uid}", withExpiry(fresh, 300), 0) # 0=永不过期,逻辑过期
return fresh
})
return val
-
-
大Key问题
现象:关注 5000 个 UP 主的深度用户,收件箱攒了上亿条记录,Redis 内存占用居高不下,运维被迫频繁扩容。
大Key的定义:
数据结构 判定阈值建议 String 单个 value 内存占用 > 10 KB(更严格的标准为 > 50 KB) Hash / Set / ZSet / List 元素数量 > 5,000 个,或总内存占用 > 10 MB 基于命令的分析方法:
redis-cli --bigkeys- 原理:底层通过
SCAN命令渐进式遍历所有 key,不会阻塞主线程。 - 局限:它只按数据类型各汇报一个最大 key(例如仅输出“最大的 String 是哪个,最大的 List 是哪个”),且针对容器类型(Hash/Set/ZSet/List)统计的是元素数量而非实际字节大小,无法列出所有超标的大 key。
- 原理:底层通过
redis-cli --memkeys(Redis 6.0+)- 原理:同样通过
SCAN遍历,但通过MEMORY USAGE对比实际物理内存占用。 - 局限:同样只记录各类型的全局前几名,且对极大的 key 计算
MEMORY USAGE时会有轻微性能开销。
- 原理:同样通过
MEMORY USAGE <key>(Redis 4.0+)- 原理:用于精准查看单个 key 所占用的内存字节数(采样估算或遍历)。
自动化分析:
- 离线解析 RDB 快照(最推荐、主流做法)
- 云厂商托管 Redis(自带自动化能力)
影响面:
- 阻塞单线程,引发服务级联超时
- 网卡打满,单机的其他服务被拖垮
- 从库因传输超时断开与主库的连接,主从失效
解决办法:
-
单个用户设置桶上限,超出上限部分通过DB读取
1
2
ZADD inbox:{uid} {publish_ts} {vid}
ZREMRANGEBYRANK inbox:{uid} 0 -501 -- 只留最新 500 条,从旧端删 -
设置Key过期时间,定期删除桶消息
1
2
ZADD inbox:{uid} {publish_ts} {vid}
ZREMRANGEBYRANK inbox:{uid} 0 -501 -- 只留最新 500 条,从旧端删
-
推/拉模式
现象:一个关注 800 人的普通用户,每次下拉刷新 feed 要 3 秒,接口 P99 全线飘红。
1
2
3
4
5
following = SELECT followee_id FROM following WHERE user_id = ? -- 查出 800 个关注
for uid in following: -- 循环 800 次
videos = SELECT * FROM video WHERE author_id = uid
ORDER BY created_at DESC LIMIT 20 -- 每人查一次
feed = merge(all_videos) -- 内存归并 800 路解决办法:
-
查询归并
1
2
SELECT * FROM video WHERE author_id IN (:800个id)
ORDER BY publish_ts DESC LIMIT 800*20 -- 拉回来再内存归并 -
加一层缓存,结合推模式
1
2
3
4
5
# 写路径:每个粉丝一条 ZADD(大 V 1000 万粉丝 = 1000 万次写)
for fan_id in get_fans(author_id):
redis.ZADD("inbox:"+fan_id, publish_ts, vid)
# 读路径:一次命令拿一页
ZREVRANGEBYSCORE inbox:{uid} {cursor.max} {cursor.min} LIMIT 0 20 -
小作者推
1
2
3
4
5
6
7
8
# 读路径:一次命令拿一页
ZREVRANGEBYSCORE inbox:{uid} {cursor.max} {cursor.min} LIMIT 0 20
func merge(inbox_items, pull_items):
result = []
while len(result) < 20 && (inbox_items || pull_items):
result.append(older_head_of(inbox_items, pull_items)) # 取两边较旧的头
return result
-
-
fanout推同步阻塞结果
现象:千万粉 UP 主点下「发布」,页面转圈 30 秒后报超时;视频其实已经入库,但粉丝几小时后才在 feed 里看到。
fanout 被放进了发布请求的事务里同步执行:
1
2
3
4
5
publish(video):
INSERT INTO video VALUES (...) -- 入库
for fan_id in get_fans(video.author_id): -- 1000 万个粉丝
redis.ZADD(inbox(fan_id), ts, video.id) -- 逐个写收件箱
return ok解决办法:
发布只发事件到 MQ,fanout 完全异步化(选定):
1
2
3
4
publish(video):
INSERT INTO video VALUES (...) -- 只做入库
mq.Publish("video.published", {vid, author_id, publish_ts}) -- 毫秒级返回
return ok